RESOURCES
Table 1. 线性与非线性解混模型的对比
|
特征 |
线性解混模型 |
非线性解混模型 |
|
原理 |
假设观测光谱是端元光谱的线性组合 |
考虑多次散射、吸收、反射等复杂物理现象,假设为非线性关系 |
|
优点 |
简洁高效、物理可解释性好、应用广泛 |
精度更高、适用性强、能更好地处理端元变异性 |
|
局限 |
复杂场景效果差、对噪声与干扰敏感、受端元变异性影响大、依赖纯像素假设 |
计算复杂度高、物理可解释性较弱、模型选择与验证困难、对数据量要求更高 |
|
适用场景 |
地物相互独立的简单场景、计算资源有限的场景 |
紧密混合或多层覆盖场景、高精度定量显微分析 |
|
典型方法 |
主成分分析(PCA)、最小二乘法、像素纯度指数(PPI)、N-FINDR、稀疏回归 |
核方法、双线性模型、自编码器、卷积神经网络(CNNs) |
2.3 光谱解混的基本流程
高光谱与拉曼光谱解混的基本流程具有相似性,但由于应用场景与数据特性不同,两类光谱技术的具体流程存在显著差异(图 4)。通常情况下,光谱数据在解混前必须经过预处理,以保证数据准确性,最大限度降低噪声的影响。预处理的具体方式很大程度上取决于应用领域:对于实验室或近距离化学分析应用(如高光谱显微成像),预处理主要聚焦于校正样品物理特性引发的光散射效应,以及扣除仪器或样品带来的基线漂移与背景荧光;拉曼光谱解混的预处理遵循相似的思路,重点去除背景荧光与其他干扰信号87。而遥感应用的核心预处理步骤则与之不同,主要包括大气校正与光谱归一化23。在高光谱与拉曼光谱解混中,端元提取都是核心步骤。端元提取可通过人工方式完成,也可通过自动化算法实现,常用的自动化方法如N-FINDR59, 60, 88 与像素纯度指数(PPI)89-91,均适用于两类光谱技术。获取端元后,下一步是估算每个像素中各端元的丰度系数,即端元对混合光谱的贡献占比。常用的丰度估计方法包括线性解混29, 92-94与非线性解混42, 46, 95, 96。在解混过程中,通常会对丰度系数施加非负约束与归一化条件,以确保结果符合物理实际。解混结果必须通过计算重构误差、分析丰度分布、评估端元合理性等方式进行验证与评估,以保证解混结果的准确性与物理解释性。解混的最终目标是刻画不同组分的空间分布,量化各组分的丰度信息,研究人员可通过分析解混结果,识别特征或物质的分布规律19, 22, 57,量化各组分的含量62, 85, 86。
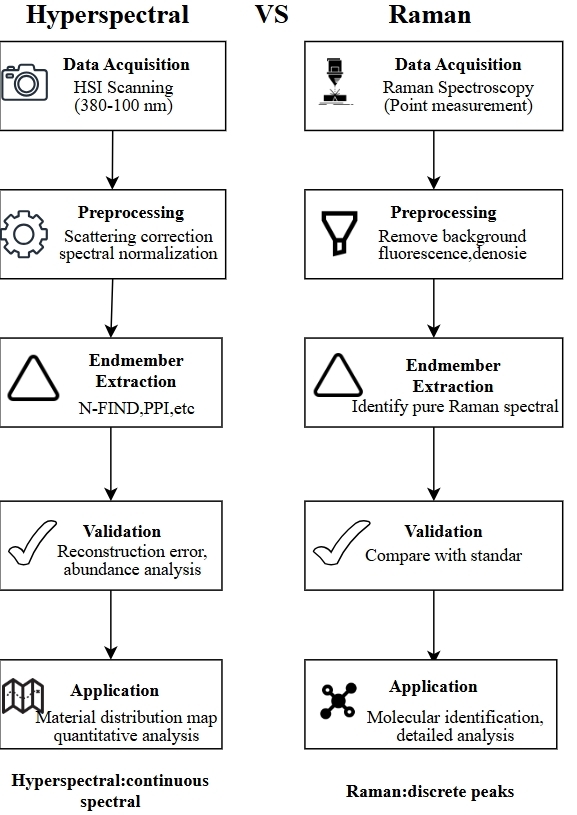
图4. 高光谱解混与拉曼光谱解混的基本流程


 13810146393
 在线咨询