RESOURCES
光谱技术在现代科技领域占据核心地位,可实现化学与生物物种的定性识别与定量分析,应用范围覆盖临床诊断1-5,药品质量控制6, 7环境监测8-15,食品安全16, 17,与材料表征18-22等诸多领域。 然而在实际场景中,尤其是分析复杂生物样本、多分析物混合物,或是组织成像、遥感探测中存在空间重叠的物种时,采集到的光谱往往因多个信号源的重叠而发生卷积。这些混合信号会阻碍光谱的直接解析,因此需要借助计算策略分离、即“解混”出各个独立光谱组分的贡献。由此,光谱解混成为一项核心分析技术,可将复杂光谱分解为其基础组分(端元)及对应的丰度分布曲线23-25。
光谱解混技术起源于化学计量学与线性代数模型,其中*具代表性的包括主成分分析(PCA)、多元曲线分辨(MCR)与非负矩阵分解(NMF)。这类方法将观测光谱视为固定或估算的纯组分光谱的线性组合23, 26。 通常假设混合过程具有加和性,且往往需要精细的初始化操作,对噪声敏感,同时需要施加各类约束条件27-31。 随着实验数据的复杂程度不断提升,荧光、散射与传感器响应中出现的非线性效应日益凸显,研究人员开始探索机器学习(ML)技术以突破上述局限。机器学习的早期应用以经典监督模型为主,包括支持向量机(SVM)、偏*小二乘回归(PLSR)与随机森林(RF),在有训练数据的前提下,这类模型在分类或定量分析中展现出了优异的性能32。
2010年代中期,该领域进入深度学习方法发展阶段33-35。 早期应用包括用于无监督特征提取的自编码器,以及面向高光谱图像解混的卷积神经网络(CNNs)36-39。这类模型能够捕捉非线性混合效应,实现跨光谱域的泛化,并对成像数据集的空间 - 光谱相关性进行建模。随后,生成对抗网络(GANs)与变分自编码器(VAEs)的出现,让研究人员能够学习光谱的潜在分布,实现端元与丰度图的模拟生成40-43。近年来,机器学习 - 物理混合模型应运而生,该类模型将领域知识融入学习过程,解决了模型可解释性与泛化性不足的问题。这一发展历程反映出该领域从数据拟合到数据表征的整体转变:机器学习工具不仅能够复现光谱混合过程,还能推断其背后的结构与物理意义44-50。
光谱解混的实际应用场景丰富多样,且仍在快速拓展。在遥感领域,研究人员通过高光谱图像解混识别土地利用类型、植被物种或矿物成分,其中每个像素都对应多种物质的混合信号22, 51-58。工业应用包括聚合物生产质量控制、燃料分析与药物制剂研发,在这些场景中,精准的光谱解析是保障产品安全与符合监管要求的核心20, 39-42。在生物医学光谱学中,解混技术可从血液、组织或细胞检测数据中识别分子物种,而这些数据中的目标光谱往往会被自发荧光、散射与背景信号掩盖1, 4-7, 59-66。在拉曼光谱与表面增强拉曼光谱(SERS)中,解混技术能够帮助研究人员分辨体液或病毒混合物中,振动特征发生重叠的多种分析物67, 68。 在环境分析领域,该技术可分离水、土壤光谱中的污染物,而这类污染物的信号往往会被天然背景信号干扰8-10, 13-15, 17。在上述所有领域中,解混技术都让光谱学从一种定性检测方法,转变为可支撑决策的定量化工具。
尽管取得了诸多进展,将机器学习融入光谱解混工作流仍面临新的挑战,包括:标记训练数据稀缺、对新仪器或新样本类型的泛化能力差、“黑箱”模型难以解释、缺乏标准化基准测试,以及稀疏性、正定性、物理守恒定律等领域特定约束的融入不足69。近年来,物理信息机器学习(PIML)与混合建模技术的发展,旨在融合数据驱动学习的优势与物理建模的严谨性,为构建透明、可解释、泛化性强的解混方案提供了极具前景的发展方向70。
本文系统综述了基于机器学习的光谱解混方法*新研究进展,探讨了各类方法的技术路径与应用场景,旨在推动光谱解混技术的理论创新与实际应用发展。图 1展示了本文的核心框架,将光谱类型划分为高光谱与拉曼光谱两大类,同时将机器学习算法分为无监督、半监督与监督三类,并清晰界定了高光谱与拉曼光谱在应用场景上的差异。第1期介绍光谱解混的基本原理与技术框架,对比线性与非线性混合模型的适用场景,分析传统解混方法的局限性。第2期全面分析了光谱解混中机器学习的监督、无监督与半监督方法,涵盖自编码器、数据 - 模型双驱动架构与深度学习融合策略,重点阐述了其在复杂场景中的泛化优势。讨论了传统线性模型的局限性,包括高光谱数据的非线性混合、端元变异性、噪声干扰,以及拉曼光谱中的荧光干扰、谱峰重叠与基线校正难题。第3期与第4期分别阐述了高光谱与拉曼光谱解混方法的*新进展,探究了其应用场景与未来挑战,同时介绍了两类技术的典型应用,印证了其在遥感、生物医学、工业检测领域的实用价值。除此之外还介绍了解混技术在其他光谱与衍射技术中的应用,并在*后总结了当前算法层面与科研生态层面的核心挑战(包括模型泛化、高维数据处理、算法可解释性、数据集共享与模型可复现性等),展望了未来发展方向,包括多源数据融合、轻量化网络设计与自动化机器学习。本章旨在推动光谱解混技术的理论创新与实际应用落地。
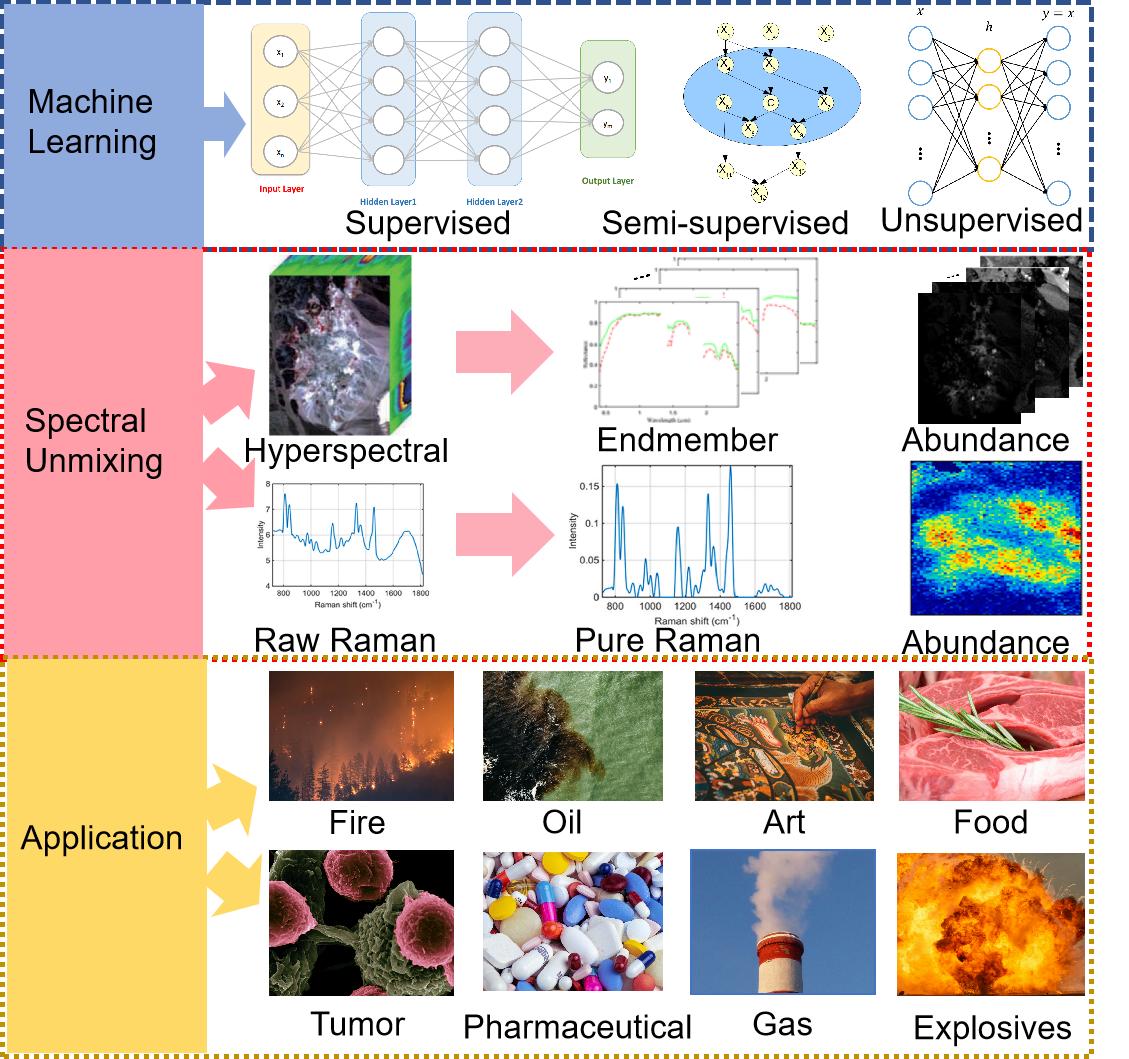
图1. 该图展示了光谱解混技术的两大分支:高光谱解混与拉曼光谱解混,以及二者基于机器学习的核心方法和典型应用场景。经参考文献71授权转载,©2022电气和电子工程师协会;经参考文献;经参考文献72授权转载,2017爱思唯尔出版集团。
与此前主要聚焦高光谱成像23,24、或是分析化学中机器学习通用应用73的综述相比,本综述具有三项独特贡献:第一,重点关注方法学创新而非单纯的应用,搭建了传统化学计量学模型与现代学习型方法之间的桥梁;第二,揭示了该领域从数学分解到学习表征的理念转变,将光谱解混置于人工智能与科学计算的整体发展趋势中;第三,提出了破解技术落地核心壁垒的研究议程,涵盖模型可解释性、不确定性量化、数据增强与实验室工作流融合等关键问题。
光谱解混是一项从复杂光谱中提取基础组分或源信号的光谱数据分析技术,主要分为高光谱解混与拉曼光谱解混两大类。其中,高光谱解混主要用于物质成分分析74,而拉曼光谱解混则聚焦于分子组分分析75。研究人员可根据具体场景与光谱特性,选择线性或非线性解混模型,对混合光谱的构成方式进行表征。光谱解混模型是实现解混的基础与工具,而解混的基本流程则是达成解混目标的操作步骤,主要包括数据预处理、端元提取、丰度估计、模型验证与评估,以及解混结果分析。该流程为整个解混过程提供了框架,而传统光谱解混方法则是实现上述步骤的具体技术手段。基于几何、统计或稀疏回归的传统解混方法,为端元提取提供了多种技术路径,其特性与局限性不仅会影响解混结果,也推动了解混技术的持续创新与发展。传统方法是光谱解混技术的基础,也为后续的方法改进与优化提供了指导。
2.1 光谱解混的定义
在光谱学领域,光谱解混的定义为:将混合光谱分解为若干基本组分,以及各组分对应占比的过程。其核心假设为:每个像素的光谱,是多种纯组分光谱以特定比例形成的线性或非线性组合。光谱解混可明确分为高光谱与拉曼光谱两类技术,二者在数据特征与底层物理原理上存在显著差异。尽管两类技术均涉及光谱数据与解混过程,但基于技术类型的分类,更能凸显二者各自面临的独特挑战与对应的方法学体系。
高光谱解混是处理高光谱数据的核心技术25, 76,其核心目标是从观测到的混合光谱数据中分离出各类纯光谱组分,并估算每个端元在混合光谱中的占比,即丰度(图 2a)77。高光谱图像通常覆盖从可见光到近红外、甚至中红外的数十至数百个光谱波段,因此每个像素都包含丰富的光谱信息。由于不同地物在多个波段的光谱特征存在相似性,解混技术通过分析这些多维光谱数据,分离代表不同物质或组分的端元。在高光谱解混中,算法不仅关注光谱信息,还会融合空间信息进行特征提取,从而提升端元识别的准确度与丰度估计的精度78。这一特性在生物医学组织分析的高光谱显微成像、药品质量控制等实验室场景中极具价值,可帮助解析药物制剂、细胞检测等复杂样本中的分子组分。尽管遥感是其经典应用场景,但遥感领域的相关方法可通过提升模型对噪声与近距离成像变异性的鲁棒性,为实验室分析提供参考8-10, 12, 17, 52, 58, 79, 80。
拉曼光谱解混是从复合拉曼光谱中分离各类化学成分的技术。与高光谱解混相比,拉曼光谱的工作光谱范围更窄,通常集中在特定波长区间,且光谱特征以离散的谱峰为核心,这些谱峰对应分子的振动模式,可反映样品的分子结构与化学组成。拉曼光谱解混的核心聚焦于光谱去噪、谱峰识别与定量分析:其流程的第一步是通过去噪技术消除测量中的噪声,确保获得清晰的光谱信号81。随后的谱峰识别是核心步骤,光谱中的特征峰与样品中的各组分直接对应,解混算法通过分析谱峰的强度、位置与峰形,识别各组分的特征峰,进而开展定量分析,估算各组分的相对含量(图 2b)82。由于拉曼光谱的特征提取高度依赖谱峰的精准识别与分析,解混算法必须具备高分辨能力与抗噪性,才能在复杂的化学或生物样本中有效分离并定量不同组分83,这也让拉曼光谱解混在材料科学18, 20, 21、化学分析16, 68, 84-86与生物医学领域1, 4-7, 59-62,尤其是复杂混合物的精准定量分析中,展现出不可替代的价值。
高光谱与拉曼光谱解混面临的挑战可分为基础共性问题与特有挑战。共性基础问题包括端元估计、端元识别、丰度估计,以及线性与非线性混合问题:其中端元识别用于确定混合像素中的纯光谱,丰度估计用于计算每个端元在混合像素中的占比,端元数量的确定则需要估算场景中存在的物质种类,而线性与非线性混合技术则用于处理物质间的复杂相互作用、或多次散射场景。尽管基础问题相近,但二者因数据特性不同,面临的具体挑战与方法学体系存在显著差异:高光谱解混主要处理高维数据与空间混合问题,常采用线性解混与深度学习技术;而拉曼光谱解混则聚焦于谱峰重叠与背景干扰问题,多使用Voigt峰补偿等方法。
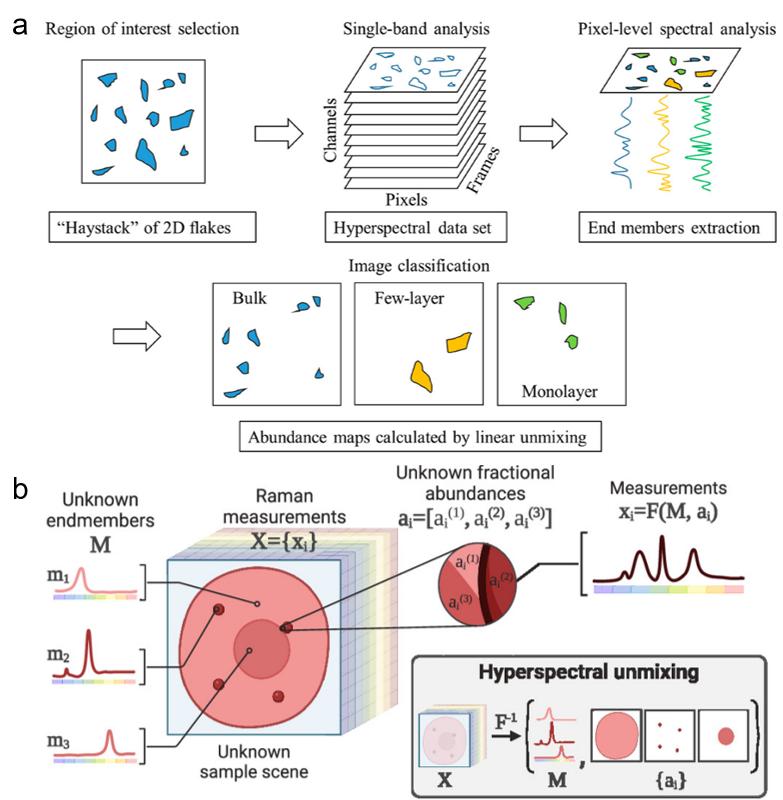
图2. 光谱解混的定义与建模。 (a)高光谱解混示意图。摘自参考文献77,©2020 美国化学会。 (b) 拉曼光谱解混示意图。摘自参考文献82,基于CC-BY 4.0许可协议发布 (https://creativecommons.org/licenses/by/4.0/;https://doi.org/10.1073/pnas.2407439121). ©2024 D. Georgiev, Á. Fernández-Galiana, S. Vilms Pedersen, G. Papadopoulos, R. Xie, M. M. Stevens & M. Barahona.
2.2 光谱解混的模型构建
线性混合模型是光谱解混中*常用的数学框架,其核心假设为:每个像素的光谱,是场景中若干纯组分(端元)光谱的线性组合。每个组分的贡献称为丰度,丰度系数代表该组分在像素中的占比。该模型的基本公式如下23:
(1)
其中, 代表观测到的混合光谱, 为第i个端元的光谱, 为第i 个端元的丰度系数。为保证解混结果的物理解释性,线性混合模型通常会对丰度系数施加约束,要求其满足非负性、和为1,即且,从而确保每个像素的光谱可通过端元的合理比例精准表征。 然而,高光谱层面的混合过程建模,远比描述地表混合物的相互作用更为复杂26,混合模型还需考虑场景中物体三维拓扑结构的影响,包括树木高度、冠层大小与密度,以及传感器的观测角度等因素(图 3a)25。线性混合模型凭借其简洁性与高效性,在光谱解混领域应用广泛,尤其适用于场景简单、组分间相互独立的场景。
非线性混合模型是为描述复杂混合现象而设计的数学框架,尤其适用于传统线性混合模型失效的场景。在真实环境中,光谱信号与其他类型数据往往会受到一系列复杂物理现象的影响,尤其是多次散射、光的吸收与反射等非线性效应的存在,会让线性假设不再成立23,此时必须通过非线性混合模型对这些现象进行精准模拟。非线性混合模型的通用形式如图3b所示25:
(2)
其中,为非线性函数,用于描述不同端元间的复杂混合关系,根据具体的混合机制,该函数可采用多项式、核函数、二次散射模型等多种形式。非线性混合模型通常需要更完善的误差处理机制,因为除常规测量噪声外,还需考虑非线性效应引入的误差。这类模型通过纳入更复杂的非线性相互作用,解决了线性混合模型在处理复杂混合现象时的局限性24。但由于其计算复杂度高、物理解释性弱,非线性混合模型的应用需要进行严谨的模型选择与验证。表1系统总结了线性与非线性解混模型的核心特征,包括基本原理、技术优势、固有局限性、典型应用场景与经典实现方法。
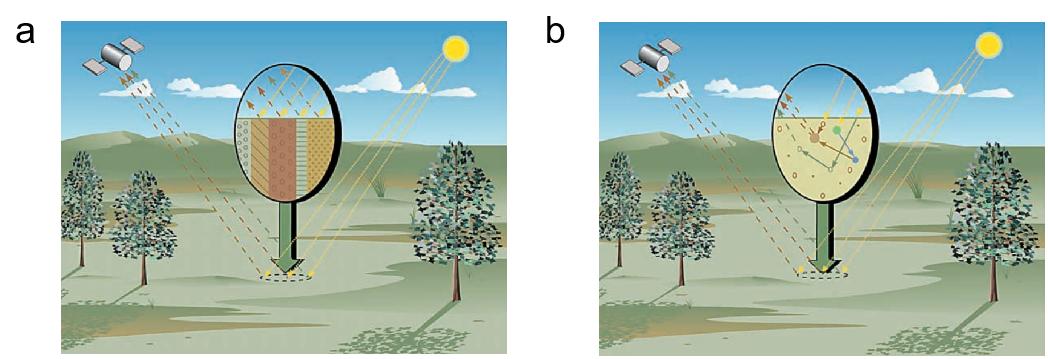
图3. 光谱解混建模。(a)线性混合示意图:入射太阳辐射经地表单次反射后出射,地表由相互独立的纯端元物质组成。经参考文献25,©2002电气和电子工程师协会。 (b)非线性混合示意图:入射太阳辐射照射到致密混合物上,引发多次反射散射。经参考文献25授权转载,©2002电气和电子工程师协会。
Table 1. 线性与非线性解混模型的对比
|
特征 |
线性解混模型 |
非线性解混模型 |
|
原理 |
假设观测光谱是端元光谱的线性组合 |
考虑多次散射、吸收、反射等复杂物理现象,假设为非线性关系 |
|
优点 |
简洁高效、物理可解释性好、应用广泛 |
精度更高、适用性强、能更好地处理端元变异性 |
|
局限 |
复杂场景效果差、对噪声与干扰敏感、受端元变异性影响大、依赖纯像素假设 |
计算复杂度高、物理可解释性较弱、模型选择与验证困难、对数据量要求更高 |
|
适用场景 |
地物相互独立的简单场景、计算资源有限的场景 |
紧密混合或多层覆盖场景、高精度定量显微分析 |
|
典型方法 |
主成分分析(PCA)、*小二乘法、像素纯度指数(PPI)、N-FINDR、稀疏回归 |
核方法、双线性模型、自编码器、卷积神经网络(CNNs) |
2.3 光谱解混的基本流程
高光谱与拉曼光谱解混的基本流程具有相似性,但由于应用场景与数据特性不同,两类光谱技术的具体流程存在显著差异(图 4)。通常情况下,光谱数据在解混前必须经过预处理,以保证数据准确性,*大限度降低噪声的影响。预处理的具体方式很大程度上取决于应用领域:对于实验室或近距离化学分析应用(如高光谱显微成像),预处理主要聚焦于校正样品物理特性引发的光散射效应,以及扣除仪器或样品带来的基线漂移与背景荧光;拉曼光谱解混的预处理遵循相似的思路,重点去除背景荧光与其他干扰信号87。而遥感应用的核心预处理步骤则与之不同,主要包括大气校正与光谱归一化23。在高光谱与拉曼光谱解混中,端元提取都是核心步骤。端元提取可通过人工方式完成,也可通过自动化算法实现,常用的自动化方法如N-FINDR59, 60, 88 与像素纯度指数(PPI)89-91,均适用于两类光谱技术。获取端元后,下一步是估算每个像素中各端元的丰度系数,即端元对混合光谱的贡献占比。常用的丰度估计方法包括线性解混29, 92-94与非线性解混42, 46, 95, 96。在解混过程中,通常会对丰度系数施加非负约束与归一化条件,以确保结果符合物理实际。解混结果必须通过计算重构误差、分析丰度分布、评估端元合理性等方式进行验证与评估,以保证解混结果的准确性与物理解释性。解混的*终目标是刻画不同组分的空间分布,量化各组分的丰度信息,研究人员可通过分析解混结果,识别特征或物质的分布规律19, 22, 57,量化各组分的含量62, 85, 86。
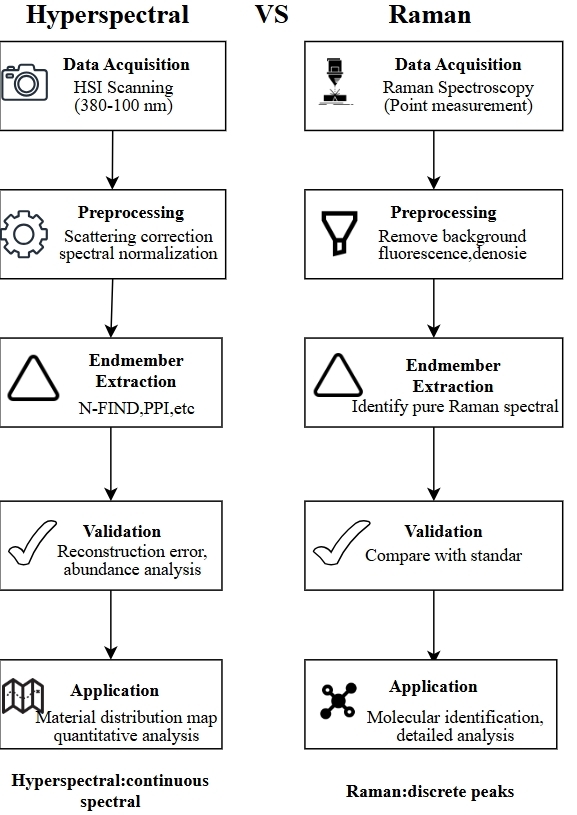
图4. 高光谱解混与拉曼光谱解混的基本流程
2.4 传统光谱解混方法
根据基本原理的不同,传统光谱解混方法可分为基于几何的方法、基于统计的方法与基于稀疏回归的方法。该分类方式反映了各类解混技术的核心思路与技术机制。基于几何的光谱解混方法利用光谱数据在高维空间中的几何结构,主要应用于高光谱解混领域;而拉曼光谱因维度较低,该类方法的应用相对较少。这类方法假设端元在光谱空间中构成几何多面体,观测到的混合光谱是这些端元的凸组合,因此解混的核心就是找到该几何多面体的顶点,并估算每个端元的丰度91, 97-99。PPI 通过持续迭代,识别光谱空间中接近纯像素的点,将这些像素视为与纯端元高度近似的对象89, 90, 100, 101。N-FINDR通过定位光谱空间中体积*大的单形体,将其顶点作为端元88, 102-105。基于凸包的方法假设所有观测到的混合光谱点都位于端元形成的凸包内,通过在光谱空间中搜索凸包的顶点实现端元识别106, 107。*小体积单形体分析(MVSA)则在 “端元形成的几何单形体体积*小、混合光谱位于单形体内部” 的前提下,通过搜索*小体积的单形体提取端元108-112。
基于统计的方法不依赖明确的物理模型,这一特性使其在拉曼光谱解混中具备独特优势,且效果远优于在高光谱解混中的表现。这类方法利用光谱数据的统计特性进行解混,通常假设端元具有独立性、互斥性等特定统计特征,通过分析这些特性估算端元及其丰度113。PCA是应用广泛的降维技术,通过提取光谱数据的主成分简化数据复杂度,为后续的解混分析提供便利114-116。独立成分分析(ICA)的核心假设为每个端元的光谱信号在统计上相互独立116, 117,通过*大化信号的独立性分离端元,与PCA关注正交性不同,ICA聚焦于信号的独立性118。*大似然估计(MLE)基于概率论,假设混合光谱可由一个概率模型生成,通过*大化观测光谱的似然函数,估算端元与丰度119, 120。
基于稀疏回归的方法凭借对大规模数据与冗余端元库的处理能力,在高光谱解混中应用广泛;而其在拉曼光谱中的应用,则聚焦于谱峰的稀疏表征,尤其适用于定量分析与物质识别。这类方法的核心假设为:光谱信号可表示为有限个端元的稀疏组合,通过施加稀疏约束,可从冗余的端元库中筛选出*相关的端元,进而估算混合光谱的丰度121-123。稀疏回归假设混合光谱由少量端元的稀疏组合构成,通过引入 L1正则化,强制丰度系数具有稀疏性,*大限度减少端元间的冗余124-126。协同稀疏回归是稀疏回归的进阶版本,不仅对单个像素执行稀疏回归,还通过多个像素间的协同识别共享端元,提升模型的鲁棒性127, 128。稀疏NMF融合了稀疏性与非负约束,通过对观测矩阵的分解,实现端元与丰度的同步估计129, 130。
上述三类方法各具特点,适用于不同的光谱解混场景与应用需求:高光谱解混因数据高维特性,主要依赖几何与稀疏类方法;而拉曼光谱解混则因谱峰特性,更适合采用统计与稀疏类方法。尽管传统光谱解混方法在过去取得了显著成果,但随着数据复杂度的提升与非线性混合现象的普遍存在,其局限性逐渐显现,包括线性假设带来的约束、对噪声敏感、依赖纯像素,以及处理高维数据与复杂混合场景时的计算瓶颈。
北京卓立汉光仪器有限公司公众号所发布内容(含图片)来源于原作者提供或原文授权转载。文 章版权、数据及所述观点归原作者原出处所有,北京卓立汉光仪器有限公司发布及转载目的在于传递 更多信息及用于网络分享。
如果您认为本文存在侵权之处,请与我们联系,会第一时间及时处理。我们力求数据严谨准确, 如有任何疑问,敬请读者不吝赐教。我们也热忱欢迎您投稿并发表您的观点和见解。


 13810146393
 在线咨询