RESOURCES
第二期:光谱解混传统线性模型的局限与挑战,及基于机器学习的解混方法与靶向策略
在上一期对光谱解混技术有一定了解的基础上,我们认识到:传统解混方法在应对当前复杂的混合模式及非线性现象时存在一定局限,而基于机器学习的光谱解混技术则展现出显著的分析优势。本期将先介绍各类机器学习方法,同时为了凸显其优势,并剖析传统线性模型固有的局限与挑战——例如为何需要更复杂的方法,并附带给出应对这些问题的光谱解混靶向策略。
3.基于机器学习的常用光谱解混方法
光谱解混的核心是将混合光谱分解为具有物理意义的端元光谱及其对应丰度。随着数据分辨率与复杂度的不断提升,传统解混方法已难以应对复杂的混合模式与非线性现象,而先进的机器学习算法则在光谱解混中展现出显著优势。本文根据学习范式的不同,将基于机器学习的光谱解混方法系统分为监督、半监督与无监督三大类。研究人员可根据数据特征与任务需求,选择适配的方法,最大限度发挥模型在解混过程中的优势(表 2)。
3.1 监督解混
监督学习是依赖标记样本进行训练的机器学习范式。在光谱解混中,该方法通常假设各类物质的端元光谱已知,核心目标是估算每个端元在混合光谱中的丰度比例31, 38, 39, 131-133。例如在高光谱图像中,单个像素可能包含土壤、植被、水体的混合反射信号94, 134,监督学习可精准分解这些组分的占比;在拉曼光谱中,可通过监督方法分辨混合样品中各分子的振动模式。
在高光谱图像领域,监督解混是最早被系统研究的解混策略之一,代表性方法为全约束最小二乘法(FCLS)。该方法在丰度非负、和为1的物理约束下,最小化混合光谱与其线性组合之间的误差135,是解混研究的基石方法。针对端元数量多、光谱库规模大的场景,Bioucas-Dias与Figueiredo提出了基于变量分裂与增广拉格朗日的稀疏解混方法(SUnSAL)136,通过引入L1正则化项提升丰度向量的稀疏性,进而提高解混效率与鲁棒性137。此外,贝叶斯监督解混方法通过对丰度或噪声施加先验分布,为不确定性建模提供了新思路,提升了模型的可解释性与容错性49。近年来,深度神经网络被越来越多地应用于高光谱解混任务,凭借其非线性建模优势,提升了模型的泛化能力与适应性38, 131。如图5a所示,典型的深度卷积网络结构包含多个卷积层、池化层与归一化模块,用于从原始高光谱数据立方体中提取光谱与空间特征,实现端元提取与丰度估计的端到端建模39。同时,该模型对多种已知端元物质的反射光谱重构结果,印证了其在光谱信息保留与高拟合精度方面的优异性能39。此外,监督学习方法在近距离高光谱图像分析中同样不可或缺。例如,Kamruzzaman等人综述了以已知食品成分光谱作为监督标签,训练深度学习网络分析食品化学成分的方法138,该方法可实现食品中添加剂、防腐剂、有害微生物的快速无损检测,适用于掺假识别、营养评估与污染物筛查。通过最小化混合光谱与其线性组合之间的误差,该监督学习方法提升了分离精度与鲁棒性,在实验条件严格可控的场景中效果尤为突出。
与高光谱成像相比,拉曼光谱主要用于微观尺度或分子层面的成分分析。监督解混基于已知化学物质的拉曼光谱构建端元,用于分析复杂混合物的成分占比。线性最小二乘法(LLS)与FCLS是拉曼解混中最常用的方法,尤其适用于实验条件严格可控的场景139。近年来,研究人员将端元变异性建模引入拉曼分析,以解决温度、激发波长、pH 等实验条件波动带来的干扰140, 141。同时,深度神经网络也逐渐融入拉曼光谱的组分识别与解混任务中142。如图5b所示,DeepCID 模型通过构建标准数据库、执行数据增强、生成正负样本对,结合预训练与多模型加载策略,提升了拉曼光谱组分识别的鲁棒性与准确率94。图5c则展示了混合物拉曼光谱与参考数据库中纯组分光谱的对比结果,验证了深度监督模型在真实混合环境中的有效性94。
尽管监督学习在光谱解混中取得了显著成果,但其仍存在若干局限性:第一,精准获取端元光谱难度较大,尤其是在开放的自然场景中,环境变化会引发光谱漂移;第二,端元光谱已知的假设并非始终成立,在拉曼光谱等实验变异性高的场景中尤为明显;第三,监督模型无法利用未标记样本,限制了数据利用效率。基于此,半监督学习成为近年来的研究热点,该方法结合少量标记数据与大量未标记样本,通过联合优化或自监督方法提升解混性能。
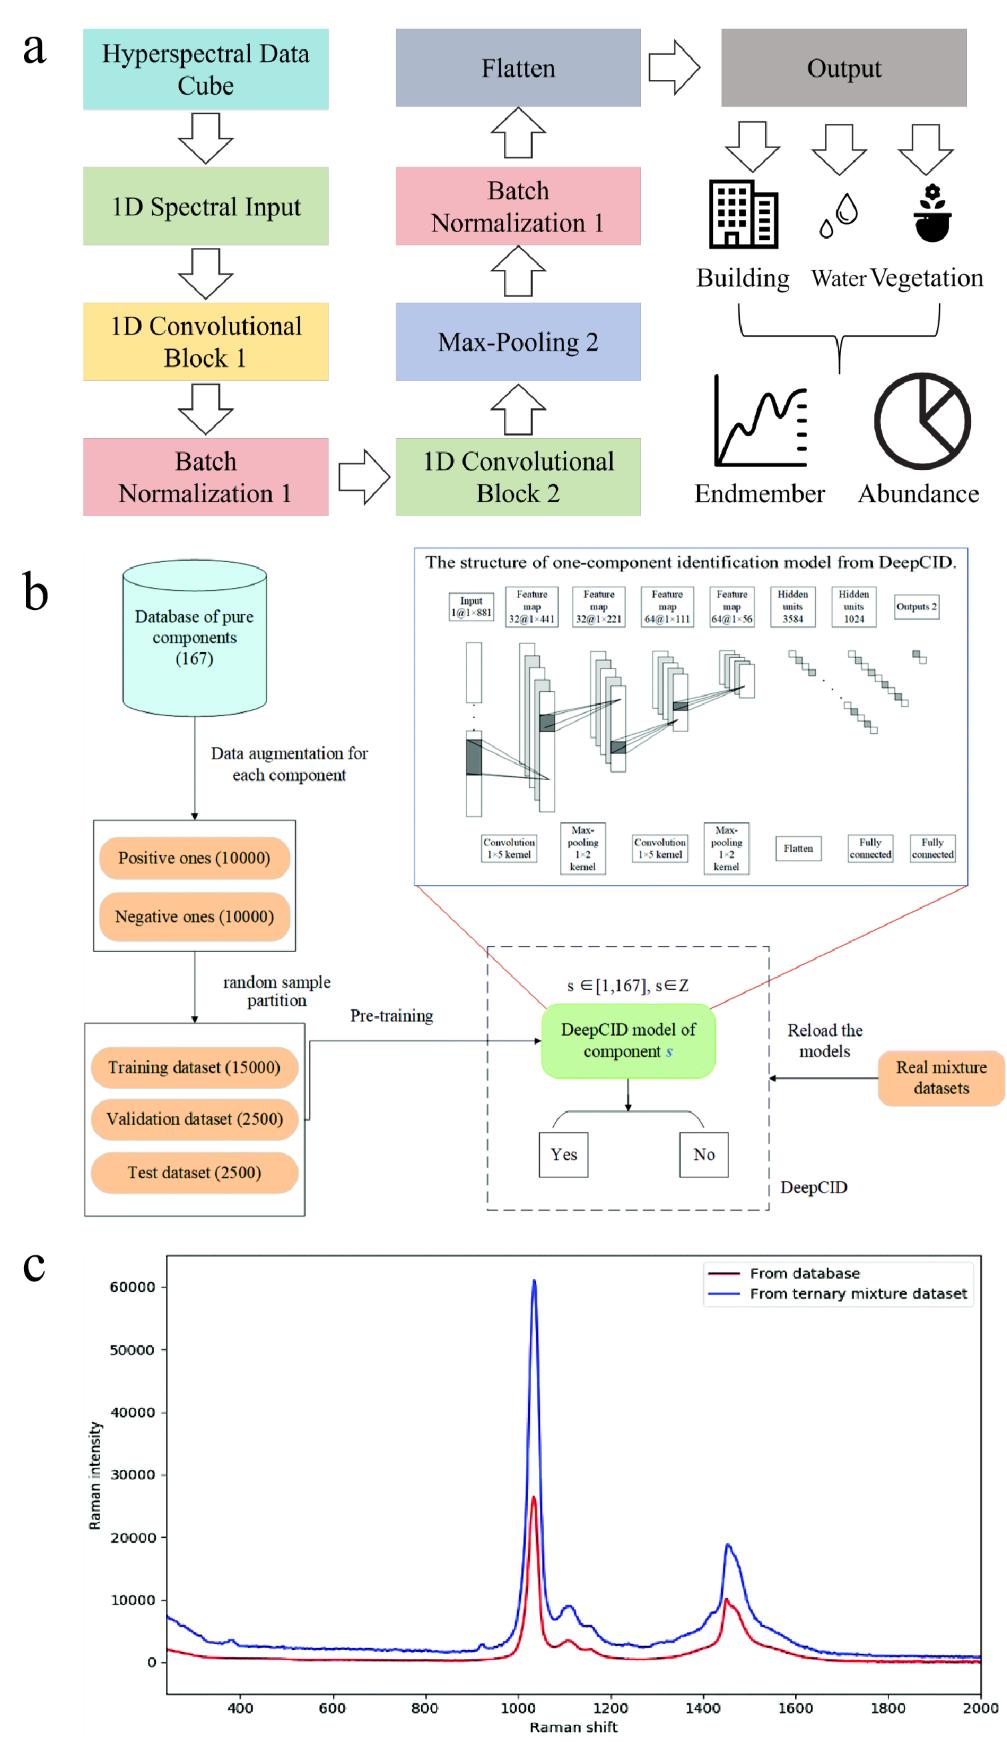
图5. (a)用于高光谱解混的深度卷积网络结构。(b) DeepCID组分识别模型的训练流程。经参考文献94授权转载,©2019英国皇家化学会。 (c)实际混合物拉曼光谱与数据库参考光谱对比。经参考文献94授权转载,©2019英国皇家化学会。
3.2 半监督解混
半监督学习非常适用于“部分端元信息已知、其余组分待挖掘”的复杂混合场景。与严重依赖先验知识的全监督方法相比,半监督学习提供了更具适应性、可解释性更强的解混策略。
在高光谱成像中,混合像素通常由多种化学成分或物质构成143-146,半监督解混方法将有限的监督信息与数据驱动建模技术相结合,有效提升了解混精度与鲁棒性。代表性的半监督方法包括半监督非负矩阵分解(SS-NMF):Sigurdsson等人提出,在标准NMF框架中,将部分已知端元作为固定先验项,仅对未知端元与丰度矩阵进行估计,实现了混合像素更高精度的建模与组分识别147。针对光谱库规模大、地形分布复杂的常见挑战,Bai等人引入稀疏约束机制,提出了稀疏正则化半监督学习(SR-SSL)方法148,该方法在估计丰度矩阵时加入L1范数正则化项,有效减少了非零丰度项的数量,提升了解混的判别能力与泛化性能。随着深度学习的广泛应用,图卷积网络(GCN)与3D CNN也逐渐融入半监督解混框架。Kong等人开发了一种半监督CNN模型,将空间上下文信息与少量标记样本联合训练,在保持高光谱像素判别能力的同时,实现了空间 - 光谱联合特征的高效提取与解混优化(图 6a、6b)144。
在拉曼光谱分析中,混合信号通常包含部分已知的背景或基质组分,而待识别的目标组分未知。这种“先验知识 + 未知目标”的场景,让半监督学习成为拉曼光谱解混的极具潜力的方法。定量无监督 / 部分监督非负矩阵分解(Q-US/PS-NMF)是拉曼领域应用广泛的半监督解混策略:Lobanova与Lobanov在分析人体动脉组织时,将石蜡包埋基质的光谱信息作为已知端元固定,仅估计与病变相关的未知组分,显著减少了伪解混伪影(图 6c)149。此外,针对拉曼动态光谱中基线漂移、信噪比波动等常见问题,Bocklitz等人开发了多元曲线分辨 - 交替最小二乘法(MCR-ALS)150,该方法将混合物分解为估计的组分光谱与伪浓度,可在建模过程中融入额外的先验知识,基于估计的组分光谱对混合光谱进行迭代分解,提升了解混模型的鲁棒性与跨样本泛化能力。
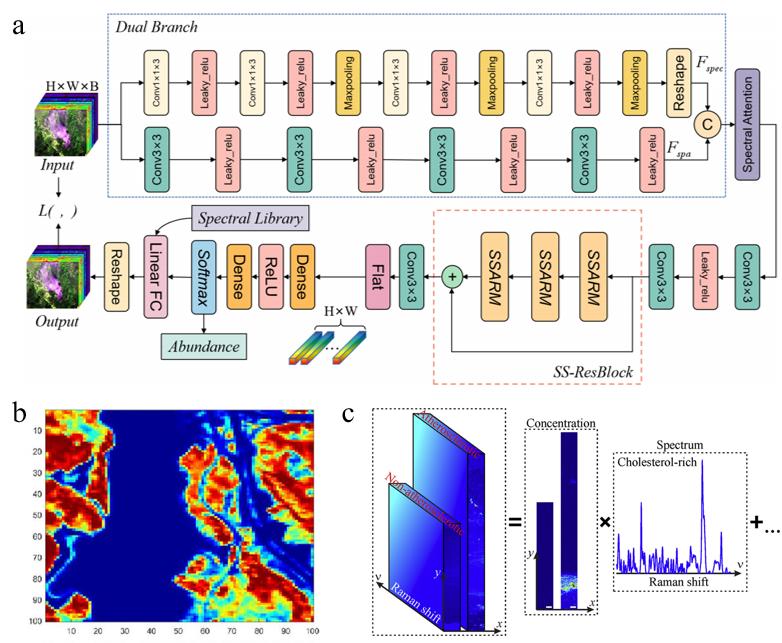
Fig. 6. (a) 具备特征提取与空间-光谱注意力融合的双分支网络结构。摘自参考文献144,(https://creativecommons.org/licenses/by/4.0/;https://ieeexplore.ieee.org/document/9760187)。©2022 电气和电子工程师协会。(b)高光谱图像中的分解组分分布图,摘自参考文献144.(https://creativecommons.org/licenses/by/4.0/;https://ieeexplore.ieee.org/document/9760187)。©2022 F. Kong, M. Chen, Y. Li & D. Li. (c)基于部分已知光谱模板的矩阵分解视角。经参考文献149授权转载。©2019爱思唯尔出版集团。
尽管半监督方法在实际场景中展现出极强的适应性,但其对先验端元的选择较为敏感,算法复杂度会随已知与未知组分的比例发生波动。基于此,无监督学习策略在光谱解混中的潜力日益凸显,包括基于自编码器、深度NMF的各类方法,其核心目标是在不依赖任何先验信息的前提下,实现高精度的光谱解混。
3.3 无监督解混
无监督光谱解混是分析混合光谱信号中潜在端元分布及其丰度的基础技术151,由于无需预定义标签或先验知识,被广泛应用于光谱数据的自动化分析。根据技术路径与算法特征,无监督光谱解混技术可进一步分为基于自编码器的解混方法、数据 - 模型双驱动解混方法,以及传统方法与深度学习结合的解混方法三大类。
3.3.1 基于自编码器的解混方法
近年来,基于机器学习(尤其是无监督学习)的自编码器,凭借强大的特征提取能力与对复杂数据集的适应性,成为光谱解混领域的研究热点76, 93, 152。自编码器是一种神经网络架构,通过编码器将输入数据压缩为低维表征,再通过解码器重构数据(图 7a)153。在光谱解混场景中,编码器用于提取丰度值,解码器则用于学习端元,可有效将光谱压缩为丰度表征并重构原始光谱。在高光谱与拉曼光谱领域,自编码器不仅突破了纯像素假设的限制,还提升了对非线性混合物的建模能力,成为无监督光谱解混方法中极具前景的技术37, 74, 152。
高光谱成像通过捕获可见光到近红外、短波红外宽波长范围的反射或发射光,提供了丰富的空间 - 光谱信息154, 155。Shahid与Schizas提出了一种基于非线性自编码器的无监督高光谱解混框架156,通过加入稀疏正则化项与物理约束,模型无需依赖纯像素假设即可实现端元提取与丰度估计,有效解决了非线性混合问题,在多个数据集上的性能均优于传统NMF与顶点成分分析(VCA)模型。Wang等人开发了3D卷积自编码器(3D-CNN-AE)架构,可同时捕捉高光谱数据中的光谱特征与空间结构155。Yu等人则提出了用于高光谱图像解混的多阶段卷积自编码器网络(MSNet)153,采用从粗到细的分步优化策略,由多个编码器 - 解码器阶段构成:前期阶段捕捉全局上下文信息,后期阶段聚焦于局部光谱细节,有效解决了传统自编码器仅关注像素级相关性的局限。
拉曼光谱数据具有谱峰稀疏、背景非线性、组分复杂的特征,近年来,自编码器方法也被引入拉曼光谱解混任务中。Schmidt等人开发的RamanLIGHT是一款图形界面工具,集成了包括自编码器算法在内的多种无监督解混方法157。其优势在于将拉曼数据的自动化预处理步骤与解混流程相结合,适用于生物成像与材料分析领域。Abdolghader等人将自编码器用于受激拉曼散射(SRS)图像增强,实现了自动化特征提取、图像分割与背景噪声抑制,印证了深度无监督架构在生物医学拉曼数据分析中的可行性158。Georgiev等人还提出了专门针对拉曼光谱解混的物理约束自编码器框架(图 7b)82。该方法解决了拉曼数据特有的噪声、基线波动、宇宙射线伪影等挑战,通过施加非负约束与丰度和为1的约束,确保自编码器输出的解混结果符合物理一致性82。
自编码器在高光谱与拉曼光谱解混中的应用,凸显了无监督学习在处理复杂光谱数据方面的潜力。但自编码器主要依赖数据驱动的特征提取,其可解释性仍不及直接融合物理模型的数据 - 模型双驱动方法。
3.3.2 数据 - 模型双驱动解混方法
数据 - 模型双驱动方法旨在融合物理模型的显式可解释性与数据驱动方法的灵活性。其中,物理模型为光谱混合提供了理论框架(如线性混合模型、Hapke模型),而数据驱动方法则通过挖掘数据中的复杂模式,提升模型的适应性159-162。传统物理驱动方法依赖固定的混合结构,往往受环境约束限制;而数据 - 模型双驱动方法可自主学习混合结构。
在高光谱成像解混中,数据 - 模型双驱动方法通常以NMF及其改进算法为核心,通过加入模型约束,提升端元与丰度估计的物理解释性45, 163-167:稀疏 通过对丰度矩阵施加L1范数约束,强化了“混合像素由有限个端元构成”的假设160;低秩NMF则通过约束丰度矩阵的秩,提升了地物混合模式的泛化能力。Rehman与Qureshi在综述中指出,这类方法已被广泛应用于矿物识别、植被分类、城市土地覆盖分析,兼具效率与可解释性的双重优势168。此外,部分方法还融入了局部空间先验,即使在地物边界模糊、组分变异性显著的场景中,仍能得到鲁棒的解混结果。
在拉曼光谱分析中,数据 - 模型双驱动方法可从背景复杂、信噪比低的混合光谱中提取有意义的化学成分169, 170。Bajomo等人提出了一种创新的基于频率计数的特征峰提取算法171。该算法可从多组分SERS光谱混合数据中自动提取高出现频率的谱峰,并基于这些谱峰进行特征降维(图 7c)。Lobanova与 Lobanov提出的定量高光谱图像解混(Q-HIU)方法,是数据 - 模型双驱动的典型代表,该方法融合了三大核心策略:(1)结合自动相关检测(ADC)的奇异值分解(SVD)用于噪声滤波;(2)底部高斯拟合(BGF)用于去除荧光背景;(3)带先验约束的NMF用于特征提取与丰度估计149。该方法在大规模拉曼显微光谱数据分析中展现出极高的效率与鲁棒性,可有效识别蛋白质、胆固醇、核酸等生物分子。此外,Bergner等人将N-FINDR算法与VCA几何算法相结合,对未干燥脑肿瘤组织的拉曼图像进行分析,融入生化知识实现了肿瘤微结构的精准识别172。
数据 - 模型双驱动方法融合了数据驱动学习与领域知识/物理模型,在有明确领域模型的场景中,可提供更强的可解释性,但其集成复杂度高、需要领域专业知识,限制了适用范围。如果模型驱动部分过于僵化,或数据驱动部分缺乏正则化,可能导致过拟合,尤其是在无标签验证的无监督学习场景中。而无监督学习中,传统方法与深度学习的融合,在提升精度的同时,凭借其固有的灵活性与数据驱动特性,在处理复杂数据方面更具优势。
3.3.3 传统方法与深度学习结合的解混方法
传统方法与深度学习融合算法的核心思路,是充分发挥传统方法的理论优势与深度学习的高效建模能力,提升解混的精度与鲁棒性92, 173。传统方法基于物理建模与理论解释,可有效捕捉光谱信号中的已知先验知识130, 141, 174, 175;而深度学习模型擅长处理复杂的非线性数据,在特征提取与模式识别方面优势显著。通常先通过传统方法对数据进行先验分析或初始解混,再基于传统方法的结果,通过深度学习进行进一步优化,提升整体性能176。
在高光谱解混中,传统与深度学习融合的方法已展现出优异的性能71, 177, 178。Palsson等人提出了一种融合自编码器结构与端元初始化的解混模型179,该方法先通过VCA等传统算法获取初始端元,再利用神经网络自编码器对端元与丰度估计结果同步优化,在不同场景中均展现出更强的鲁棒性与非线性适应性。Borsoi等人引入深度生成模型模拟端元分布,提升了对复杂混合像素的建模能力180。与仅依赖传统几何假设的方法相比,该生成模型有效缓解了混合像素导致的性能下降。 此外,图像融合与联合解混也成为研究热点。例如,de Juan等人提出将MCR-ALS与深度网络结构相结合,通过端元与丰度的同步优化提升解混性能174。这些方法凸显了传统与深度学习方法在高光谱领域的互补性,尤其适用于矿物识别、农业监测、地表分类等应用场景。
在拉曼光谱分析中,传统解混算法因谱峰重叠、背景荧光、非线性效应的普遍存在,性能受到限制,而深度学习模型与传统方法的融合在该领域展现出巨大潜力。Belhaouari等人提出了 DeepRaman 架构,该架构受渐进傅里叶变换(PFT)启发,融入了尺度图变换方法181。通过PFT将SERS光谱转换为尺度图图像,结合 DenseNet 201进行特征提取,再执行K近邻(KNN)分类。尽管该架构主要面向分类任务,但其特征提取过程可作为解混的预处理步骤,通过融合时频信息提升谱峰分离能力。图7d展示了频域变换(FFT)在光谱特征提取中的工作流程181。此外,Pan等人强调了在拉曼光谱解混中融合多种分析方法的重要性,印证了其在食品、制药、医学样品分析中的鲁棒性与适用性182。这类方法的共同特征,是将传统光谱知识融入深度学习模型,让模型训练更具鲁棒性,同时具备更强的物理解释性。
传统方法与深度学习的融合,为无监督光谱解混注入了新的活力,但这类方法仍面临诸多挑战,包括对传统方法固有假设的依赖、深度模型设计的复杂性,以及对数据量的高要求。未来研究应聚焦于开发更统一的端到端融合框架,以及小样本、弱监督、自监督学习策略,缓解深度学习对数据量的高需求,让融合模型不仅能实现更高的精度,还能具备更强的泛化性与可靠性。
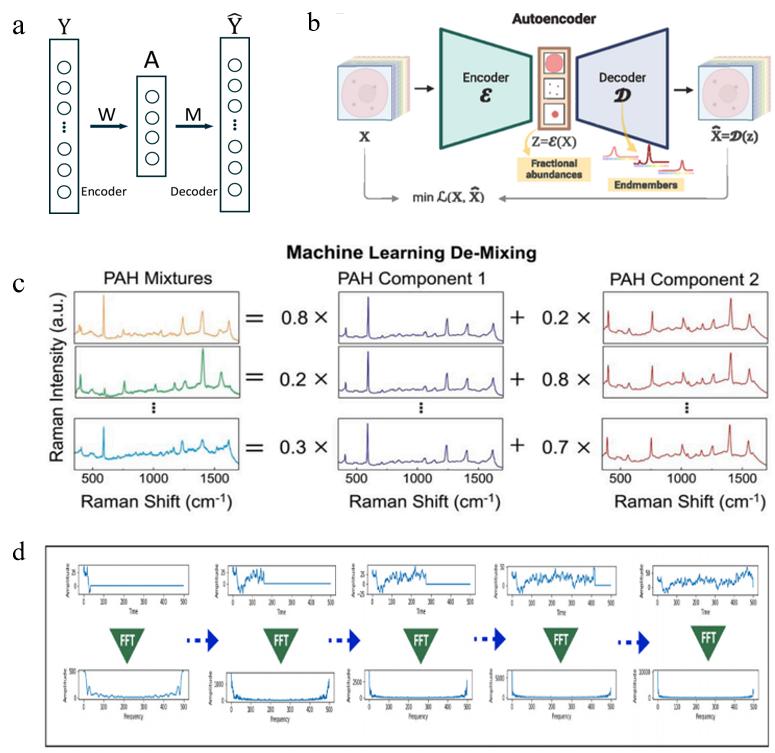
图7. (a)用于估计端元和丰度的典型自编码器结构。经参考文献153授权转载,©2022爱思唯尔出版集团。(b)物理约束型自编码器。摘自参考文献82,基于CC BY 4.0知识共享许可协议发布 (https://creativecommons.org/licenses/by/4.0/;https://doi.org/10.1073/pnas.2407439121).©2024D. Georgiev, Á. Fernández-Galiana, S. Vilms Pedersen, G. Papadopoulos, R. Xie, M. M. Stevens & M. Barahona. (c)解混示意图。多环芳烃(PAH)光谱混合及机器学习组分重构演示。摘自参考文献171,基于CC BY-NC-ND 4.0知识共享许可协议发布(https://creativecommons.org/licenses/by-nc-nd/4.0/;https://doi.org/10.1073/pnas.2211406119).©2022 M.M. Bajomo, Y. Ju, J. Zhou, S. Elefterescu, C. Farr, Y. Zhao, O. Neumann, P. Nordlander, A. Patel, & N.J. Halas. (d) 频域(FFT)变换在光谱特征提取中的应用。摘自参考文献181,(https://creativecommons.org/licenses/by/4.0/;https://doi.org/10.1016/j.heliyon.2025.e42550). ©2025 Belhaouari, S. B., Talbi, A., Elgamal, M., Elmagarmid, K. A., Ghannoum, S., Yang, Y., Zhao, Y., Zughaier, S. M., & Bensmail, H.
表2. 传统方法与机器学习方法对比
|
类别 |
代表方法 |
优势 |
局限 |
应用场景 |
Ref. |
|
几何方法 |
像素纯度指数(PPI)、N-FINDR、顶点成分分析(VCA) |
(VCA)直观可解释,无需标记数据 |
依赖纯像素假设,对噪声敏感 |
高光谱成像端元提取、线性混合模型 |
101, 104, 105 |
|
统计方法 |
主成分分析(PCA)、独立成分分析(ICA)、最大似然估计(MLE) |
抗噪声能力强,无需纯像素假设 |
统计独立性假设可能失效 |
拉曼/傅里叶变换红外光谱(FTIR)谱峰分离、组分识别 |
183 |
|
稀疏回归 |
套索算法(Lasso)、变量分裂增广拉格朗日稀疏解混(SUnSAL) |
适用于大型光谱库,稀疏性可控 |
需要高质量光谱库,对共线性敏感 |
城市与矿物高光谱解混 |
123, 128 |
|
贝叶斯方法 |
贝叶斯非负矩阵分解(NMF)、狄利克雷过程模型 |
可建模不确定性,灵活性高 |
计算成本高,推理负担重 |
非线性解混、不确定性量化 |
33, 184 |
|
图模型 |
图拉普拉斯正则化 |
可捕捉空间相关性,鲁棒性强 |
需要图先验,计算开销大 |
空间约束高光谱解混 |
125, 185 |
|
监督学习 |
监督卷积神经网络(CNN)/ 自编码器 |
精度高,充分利用标记数据 |
需要大规模标记数据集,易过拟合 |
非线性高光谱解混、复杂拉曼 /FTIR分析 |
131, 132 |
|
半监督学习 |
基于图的半监督学习、半监督卷积神经网络 |
标签利用效率高,可利用无标记数据 |
对标签噪声敏感,泛化能力依赖数据质量 |
少标记高光谱解混、跨域自适应 |
143, 144 |
|
自编码器类 |
自编码器、变分自编码器(VAE) |
无需标签,自动特征提取. |
可解释性差,计算成本高 |
线性与非线性混合、拉曼谱峰分解 |
40, 42, 43 |
|
深度生成模型 |
生成对抗网络(GAN)、扩散模型 |
可生成端元分布,非线性建模能力强 |
训练不稳定,数据需求量大 |
合成混合光谱、数据增强 |
186 |
|
数据 - 模型混合(物理驱动) |
物理信息神经网络(PINN)、物理约束自编码器、非负矩阵分解变体 |
融入物理先验,提升物理一致性 |
需要物理先验知识,计算成本高 |
多模态光谱分析、端元变异性处理 |
82 |
|
传统+深度学习混合 |
卷积神经网络+传统方法融合、深度残差网络 |
结合传统方法稳定性与深度学习能力 |
模型复杂,训练难度大 |
高光谱分类与解混、混合光谱分析 |
95, 187 |
|
张量与多模态 |
耦合非负矩阵分解、多模态融合卷积神经网络 |
融合多模态信息,挖掘时空特征 |
需要多模态数据,配准难度大 |
高光谱 - 拉曼联合解混、跨模态识别 |
188 |
|
时频方法 |
小波变换、连续小波变换(CWT)、短时傅里叶变换(STFT)+深度学习 |
适用于非平稳信号,提升光谱分辨率 |
参数选择复杂,对噪声敏感 |
拉曼基线校正、复杂谱峰分离 |
189 |
4.传统线性模型的局限性与挑战
长期以来,众多传统线性解混方法为光谱混合分析奠定了理论与方法学基础56, 65, 174。但在复杂的真实场景中,这类方法往往面临诸多局限与挑战,核心原因在于:线性混合模型通常假设观测光谱是有限个端元光谱的线性加权组合,且这些光谱在时间与空间维度上保持恒定。而在实际情况中,光谱会受到物理过程、环境条件、传感器特性等多种因素的影响,导致观测信号中普遍存在非线性效应、端元变异性、空间异质性与噪声干扰等问题。为有效突破这些挑战,必须开发更灵活、鲁棒性更强的建模方法,推动光谱解混技术在复杂真实环境中的应用41, 43。
4.1 高光谱成像解混面临的挑战
高光谱数据通常包含数十至数百个光谱波段,捕获了地物的反射光信息。但传统线性解混模型假设混合像素的光谱特征是纯端元光谱的线性组合,该假设仅在理想条件下成立,真实场景中的数据往往具有极高的复杂度,导致线性模型性能大幅下降。造成这种复杂混合的主要来源包括非线性效应、端元变异性与外部干扰因素(表 3)。
4.1.1 非线性混合效应
线性混合效应的原理基于光子与物质的单次相互作用24, 155。线性混合模型假设混合像素的光谱组成是端元光谱的线性加权和,但在实际场景中,光子可能发生多次散射或反射,导致混合信号呈现二次或更高阶的非线性形式。大气散射、多次反射、紧密混合等场景,都会导致混合光谱偏离线性加权形式。例如在植被覆盖区域,多层植被结构会引发光的多次反射,引入非线性偏差42;而在城市、矿区等异质地表场景中,物质间的物理相互作用会进一步加剧这一问题,导致端元丰度估计出现偏差,无法准确反映真实的地表组成43。这一挑战在实验室与近距离分析中同样显著:在高光谱显微成像中,当光子穿透较厚或致密的生物样本时,会发生复杂的多次散射,这一现象与植被冠层中的多次反射效应高度相似。
针对这一挑战,可采用双线性混合模型(BLMM)、多项式后非线性模型(PPNMM)等非线性解混模型46。通过引入相互作用项模拟非线性效应;也可使用核最小二乘等基于核的方法,将非线性问题映射到高维线性空间190。此外,神经网络解混等深度学习方法,可通过学习复杂的非线性关系,提升丰度估计的精度190。
4.1.2 端元变异性
端元光谱的时空变异性是另一项重大挑战33, 34, 46, 50, 167, 191-193。这种变异性源于环境因素导致的端元光谱形状或强度变化,例如大气条件改变吸收峰位置、土壤湿度影响反射率等,可分为空间变异性与时间变异性两类。这会导致线性模型中使用的端元库无法精准表征所有像素,进而引发系统误差。线性模型通常假设端元光谱保持恒定,但同一端元的光谱会因土壤湿度、植被生长阶段、大气条件等因素发生显著变化。例如在干旱地区的高光谱图像中,植被端元的变异性会导致线性解混的分类精度下降 15%~30%。这种变异性不仅增加了端元提取的难度,还可能引发奇异值问题,导致解混过程失稳。传统最小二乘等方法往往无法有效处理这种变异性,需要加入鲁棒性约束以缓解其影响。在制药领域,活性药物成分(API)的端元光谱,也会因晶型、水合状态、粒径的差异发生显著变化。
对应的解决方案包括:通过参数化建模表征端元变异性的扩展线性混合模型(ELMM)194;为每个像素选择最优端元子集的多端元光谱混合分析(MESMA)195;通过先验分布估计变异性的贝叶斯可变端元解混方法170;以及可自主学习端元分布的 VAEs 等深度学习技术161。
4.1.3 噪声与背景干扰
高光谱数据易受传感器噪声、大气吸收与散射的干扰124。其中,噪声与大气干扰的原理包括:热噪声、散粒噪声引发的随机波动;水汽吸收等大气干扰会衰减特定波长的信号,而散射则会增加背景噪声。这些干扰会破坏线性模型的纯度假设,增加端元提取与丰度估计的偏差,在高维数据中还会引发维数灾难问题。在沙漠、海洋等低覆盖度区域,丰度估计的均方根误差会急剧上升。尽管实验室与近距离应用中不存在大气效应,但仍存在类似的干扰:例如在显微成像中,仪器噪声与样品异质性引发的光散射,与遥感中观测到的散射现象高度相似,必须进行校正才能实现细胞或组织的精准分析196, 197;在制药与食品分析中,光谱仪的传感器噪声、容器与环境光等来源的背景干扰,也会降低数据质量198-200。
研究人员提出了多种应对措施:第一,在预处理阶段采用 PCA、小波变换滤波等降噪技术,缓解观测数据中的随机噪声82;第二,采用大气校正模型,如快速视线大气分析超立方体(FLAASH)、太阳光谱卫星信号二次模拟(6S)模型,模拟并校正散射与吸收引发的大气效应201;在实验室场景中,常用多元散射校正(MSC)、标准正态变量(SNV)散射校正与背景扣除算法,通过去除与样品无关的信号提升光谱纯度;最后,近年来开发的降噪与解混联合框架,可在解混过程中同步对噪声与干扰进行建模,得到更鲁棒的结果154。
4.2 拉曼光谱解混面临的挑战
拉曼光谱解混旨在从复杂信号中分离分子振动特征,揭示样品的化学组成与结构细节。但传统线性方法受限于信号强度弱、干扰复杂等问题,在生物医学与材料分析中往往难以满足需求。拉曼解混的常见挑战包括荧光背景干扰、光谱重叠,以及数据采集的固有局限(表 3)。
4.2.1 荧光干扰
荧光背景是拉曼光谱中最常见的挑战81。荧光干扰的原理为:样品分子吸收光子后,会在更长波长处重新发射光子,产生宽带背景,其强度远超拉曼散射信号,导致基线抬升,掩盖了窄带的拉曼峰,在内源性荧光占主导的生物样品中尤为明显。荧光信号的强度通常比拉曼信号高几个数量级,会掩盖微弱的拉曼峰,而线性解混假设这种非线性的荧光贡献可忽略不计,最终会导致基线漂移与峰形畸变。
时间门控技术利用荧光寿命通常短于拉曼信号寿命的特性,在时域上实现信号分离202;位移激发拉曼差分光谱(SERDS)则采用双波长激发,通过计算差分光谱有效消除荧光背景203。此外,随着人工智能技术的发展,深度学习方法已被用于荧光与拉曼信号的自动分离,展现出极强的适应性与鲁棒性。
4.2.2 谱峰重叠
拉曼谱峰分布密集,在多组分混合物中会发生严重重叠。谱峰重叠的根源在于:不同分子的振动模式具有相近的能量,导致其谱峰出现在相近位置。在多组分混合物中,这种重叠会让线性解混的丰度矩阵呈现病态,增加反问题的不稳定性。线性模型难以区分相似的振动模式,例如细胞与聚合物分析中常见的C-H键与O-H键的重叠峰;同时,谱峰重叠还会增加解析难度,需要借助先进的多元分析方法实现有效分离,而线性假设往往会产生伪峰或造成信息丢失。
针对谱峰重叠问题,MCR-ALS通过交替最小二乘迭代结合化学约束,实现重叠峰的分离50, 193;在数据驱动方面,深度学习模型可自主学习并提取复杂的峰形特征,有效分离重叠信号40;此外,物理约束模型通过融入峰宽、峰形等先验信息,进一步提升了峰解混的精度与可解释性204。
4.2.3 基线校正与数据解析挑战
基线漂移主要由仪器不稳定性或样品异质性引发,通常呈现多项式或指数变化规律,线性模型难以处理这种非平稳背景。此外,峰位偏移、峰宽变化等问题,进一步增加了数据解析的复杂度,而线性模型无法有效捕捉这些变化。在复杂生物体系中,这种局限性会导致定量结果失准,因此必须采用非线性或物理约束模型。
常用的自动化基线校正算法,如airPLS与ALS,无需人工干预即可快速去除背景趋势205;基于连续小波变换(CWT)的方法,可通过多尺度分析实现信号与基线的分离206;基于Voigt函数峰形拟合的物理模型方法,通过融入光谱产生的物理机制,提升了拟合精度204。此外,多模态融合策略通过融入先验知识、结合互补的表征方法,提升了基线校正效果与结果的可解释性。
表3. 面向问题的光谱解混靶向策略
|
光谱类型 |
问题 |
描述 |
可组合靶向策略 |
参考文献 |
|
高光谱 |
非线性混合效应 |
大气散射、多次反射、紧密混合等非线性光子相互作用,导致光谱偏离线性加权模型 |
多线性/双线性或核方法(如BLMM、PPNMM);CNN/自编码器;物理约束损失函数(如Hapke模型) |
147, 187 |
|
高光谱 |
端元变异性 |
土壤湿度、植被生长等环境因素导致端元光谱时空变化,光谱库无法表征所有像素 |
可变端元模型(如ELMM);生成式端元建模(如MESMA);迁移/域自适应;基于VAE的端元分布学习 |
48, 170 |
|
高光谱 |
噪声与大气干扰 |
热噪声/电子噪声等传感器噪声、大气吸收/散射,破坏线性假设,引发维数问题与过拟合 |
噪声建模损失函数;鲁棒估计器(如WLS);基线校正;自监督去噪自编码器(如 PCA/小波变换);大气校正模型(如FLAASH) |
124 |
|
高光谱 |
空间分辨率限制 |
空间分辨率低导致无纯像素,违背纯像素假设,放大非线性/噪声效应 |
结合光谱库的稀疏回归;MCR-ALS;无监督自编码器;亚像素映射(如PSM) |
78, 207 |
|
高光谱 |
高维数/冗余性 |
光谱维度高带来数据冗余,提升计算复杂度与噪声敏感性 |
波段选择/注意力机制;降维(如自编码器/PCA);低秩张量分解 |
114 |
|
高光谱 |
标注数据稀缺 |
标记数据不足,端元与丰度标注难以获取 |
半监督 / 自监督与对比学习;生成模型合成数据;扩散模型或变分推断框架 |
82 |
|
拉曼光谱 |
荧光干扰 |
荧光背景远强于拉曼信号,导致基线抬升、峰形畸变 |
多线性/双线性或核方法;CNN/自编码器;物理约束损失(如时间门控、SERDS);近红外激发 |
202, 203 |
|
拉曼光谱 |
谱峰重叠 |
谱峰分布密集导致重叠,难以分离相似振动模式 |
高分辨率/特征工程;基于注意力的关键波段选择;稀疏/组稀疏模型、MCR-ALS;基于CNN的谱峰特征学习 |
50, 57, 193 |
|
拉曼光谱 |
低信噪比与灵敏度问题 |
拉曼信号微弱易受噪声干扰,低信噪比引发解混误差 |
噪声建模损失函数;鲁棒估计;自监督去噪自编码器;SERS增强;光谱平均 |
116 |
|
拉曼光谱 |
基线校正与解析难题 |
基线漂移、峰位偏移、峰宽变化超出线性假设,降低可解释性 |
噪声建模损失;基线校正(如airPLS/CWT);物理建模(如Voigt拟合);自监督去噪自编码器 |
205, 206 |
|
拉曼光谱 |
端元变异性 |
温度、老化、样品制备差异导致端元光谱变化 |
可变端元模型;生成式端元建模;迁移/域自适应 |
208 |
|
拉曼光谱 |
无纯像素/纯峰 |
无纯谱峰导致端元提取困难 |
结合光谱库的稀疏回归;MCR-ALS;无监督自编码器 |
75 |
作者简介
免责说明
北京卓立汉光仪器有限公司公众号所发布内容(含图片)来源于原作者提供或原文授权转载。文 章版权、数据及所述观点归原作者原出处所有,北京卓立汉光仪器有限公司发布及转载目的在于传递 更多信息及用于网络分享。
如果您认为本文存在侵权之处,请与我们联系,会第一时间及时处理。我们力求数据严谨准确, 如有任何疑问,敬请读者不吝赐教。我们也热忱欢迎您投稿并发表您的观点和见解。


 13810146393
 在线咨询